|
滑块和点选验证码的破解思路拆解:为什么注册机越来越难,而滑块正在普及 如果你去问一个写爬虫或注册机的人,2026 年最不想碰的验证码是什么,答案大概率不是那些歪歪扭扭的字母数字,而是滑块和点选。 字符验证码的破解链路短得可怜:截图、OCR、填答案,三步结束,而且每一步都可以独立复用。滑块和点选则完全不同。它们的破解思路不是“解一道题”,而是“同时骗过一套持续变动的行为检测系统”。这篇文章把这两类验证码的常见破解思路拆开来看,目的不是教人绕过,而是说明一件事:当绕过成本被推到某个临界点之后,注册机和批量脚本的生存空间就会急剧收缩,而滑块和点选成为默认选择,恰恰是这个成本核算的结果。 滑块验证码:你以为在解拼图,其实在被测行为很多人对滑块的误解在于,以为核心是“把缺口对上”。这个误解在五年前或许还成立,今天则完全不是。 滑块验证码服务端真正采集的信号至少分四层:缺口位置匹配、滑动轨迹特征、浏览器环境指纹、请求参数加密。这四层的破解难度依次递增,而大多数公开的“破解教程”只覆盖了第一层和第二层的一半。 第一层,缺口定位。 这是最简单的一步。对于背景图和滑块图分离的验证码,OpenCV 模板匹配或边缘检测就能算出缺口的大致横坐标。一张背景图、一张带缺口的滑块图,灰度化、Canny 边缘检测、模板匹配,几十行代码就能给出一个像素级的偏移量。如果验证码没有做额外的图像混淆,这一步的难度确实不高。 第二层,轨迹模拟。 知道距离之后,不能直接 move_to 一步到位。Selenium 的 ActionChains 配合随机步长、随机停顿、Y 轴微小抖动,可以生成一条看起来“不那么机器”的拖动曲线。常见的做法是先加速、后减速,模拟人手接近目标时的微调。这一层的门槛中等:写一个能跑通的拟人拖动不难,但要稳定通过商业验证码的行为模型,需要反复调参。 第三层,环境伪装。 ChromeDriver 启动的浏览器默认带着 navigator.webdriver = true 的标记,这是最容易被检测到的破绽。通过 CDP 注入脚本抹掉这个属性、禁用自动化扩展、修改 navigator.plugins 和 languages,是一套标准操作。但环境伪装的难点不在于“改”,而在于“改得够真”。商业验证码会检测大量浏览器特征的一致性,一个参数对不上就可能触发额外验证。 第四层,参数加密。 这是绝大多数公开教程止步的地方。滑块的轨迹数据在前端提交之前,通常会被 JavaScript 加密成一个签名参数(比如极验的 w、腾讯的 collect/eks)。这个加密逻辑可能涉及 AES、RSA、自定义 Base64,而且会随版本更新。要绕过这一层,要么逆向 JS 加密逻辑,要么用 Node.js 的 jsdom 或沙箱环境直接运行官方 JS,让 SDK 自己算出签名。 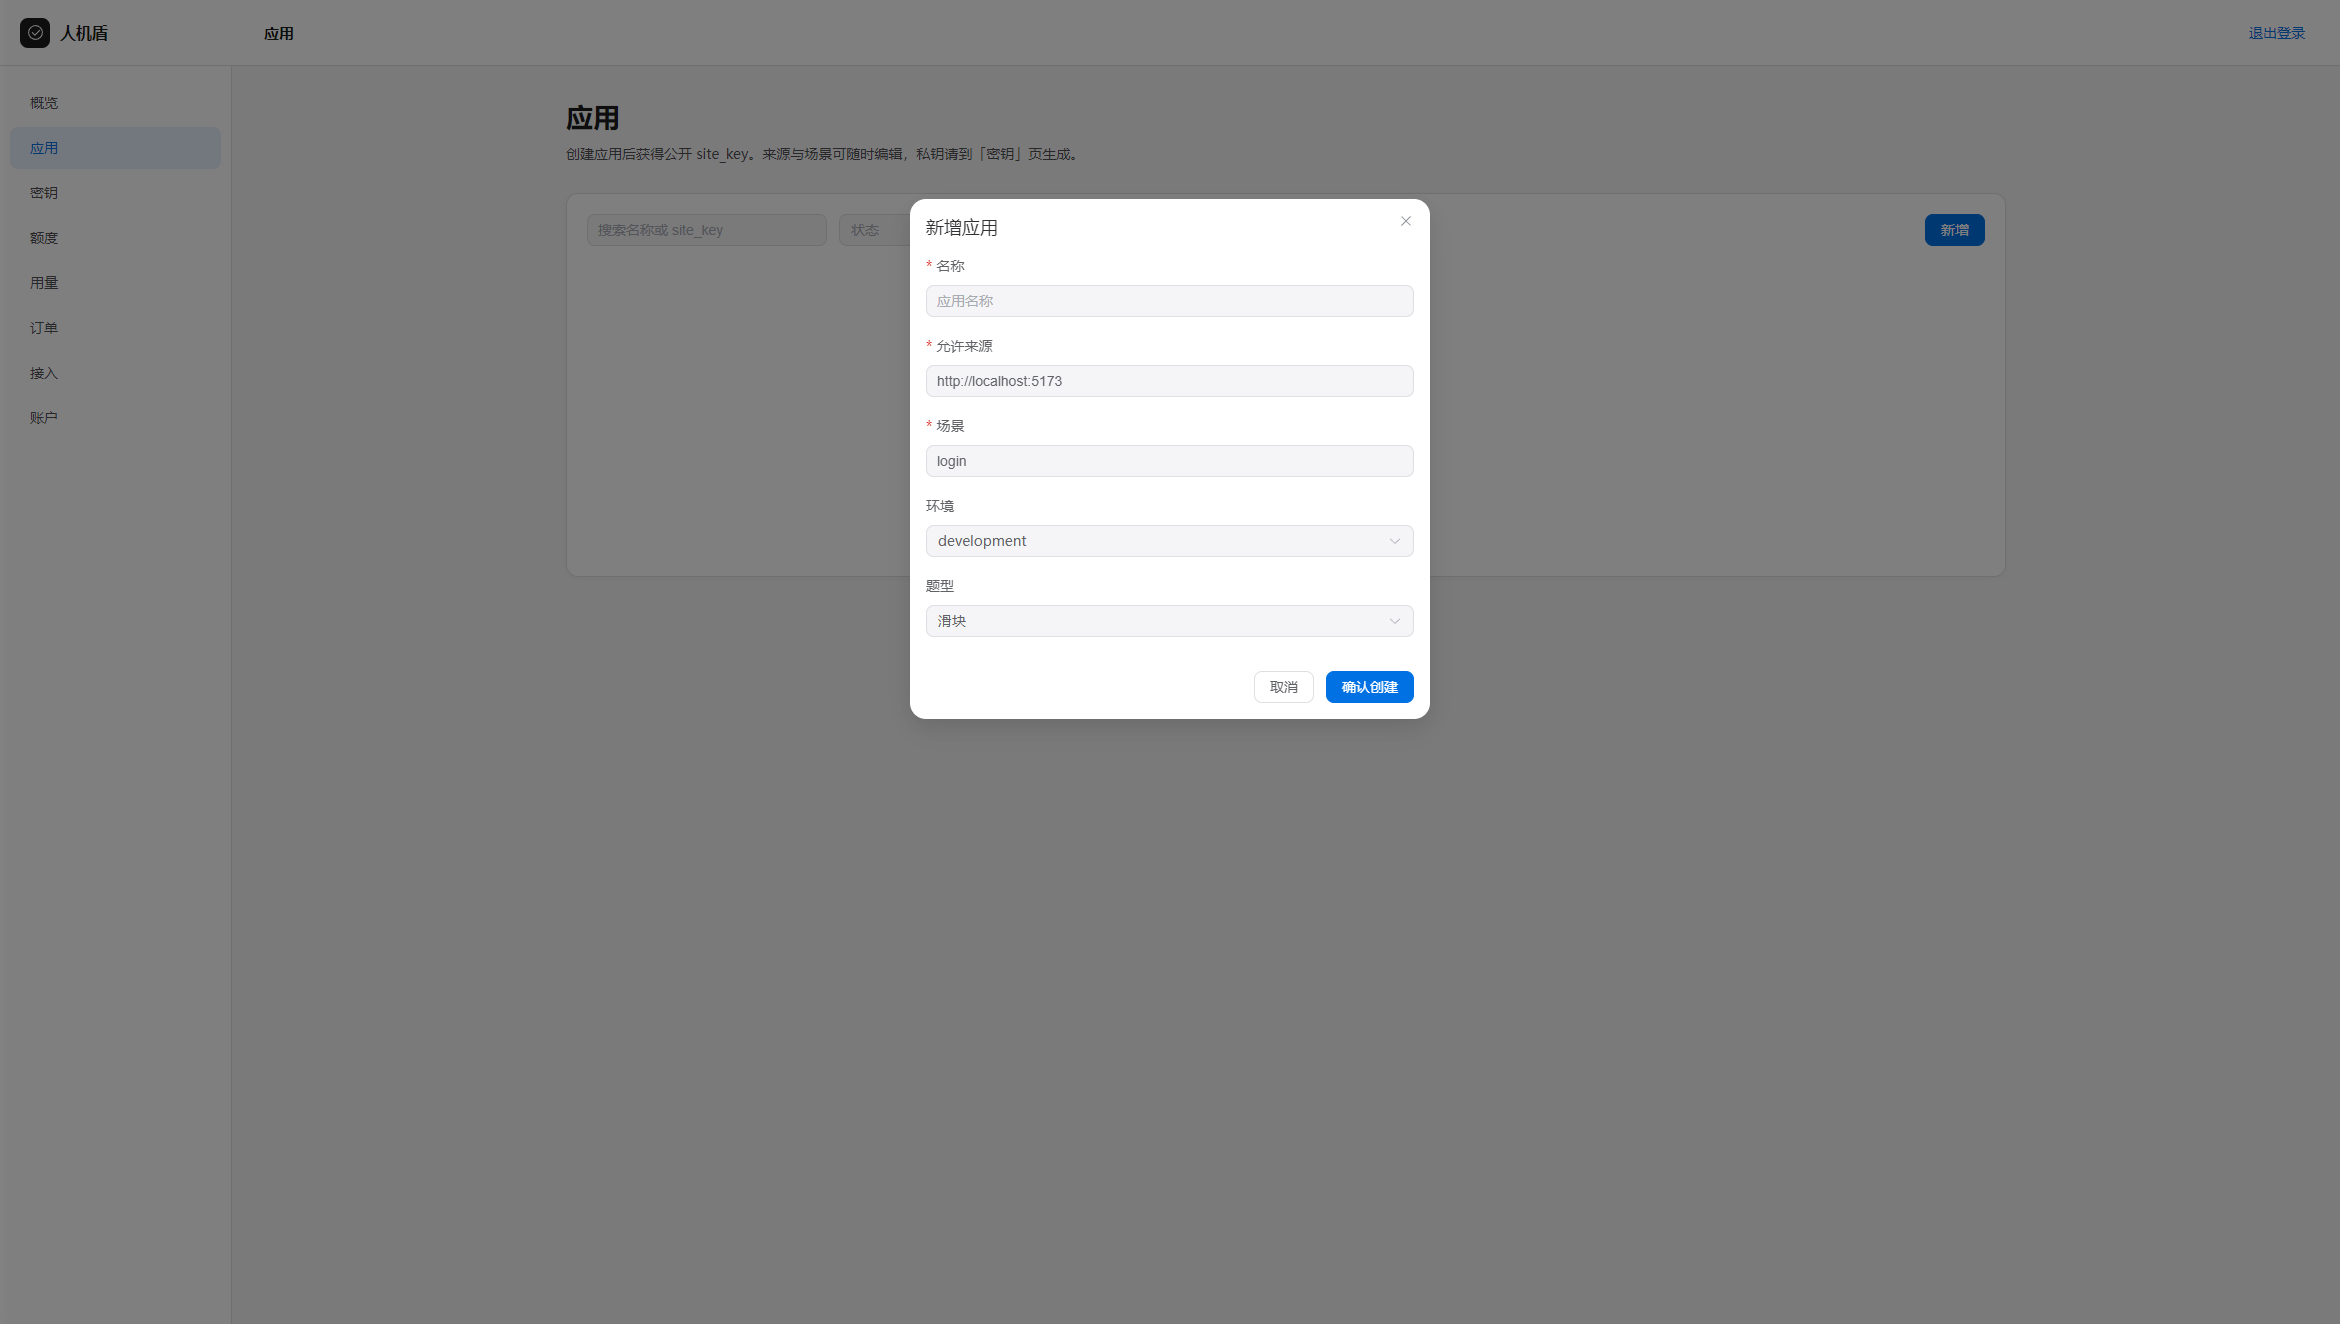 四层叠加之后,一个“能跑通”的滑块破解方案,工程量已经从一个下午的脚本变成了一个需要持续维护的小项目。而且这还没有算上题面的动态更新:每次背景图、缺口形状、缩放比例变化,缺口定位和坐标映射关系都要重新校准。你花两周调稳的参数,可能一次版本更新就作废了。  点选验证码:从“找缺口”升级到“理解语义”点选验证码把难度又往上推了一档。 滑块至少还给你一个明确的视觉目标——缺口在那里,把滑块拖过去就行。点选则要求你先理解指令,再定位目标,最后按顺序提交坐标。常见的题型包括“依次点击图中的文字”“按顺序点击图标”,以及更复杂的语义指令。 破解点选的思路大致分两条线。一条是纯视觉路线:用 YOLO 或 OCR 检测出图中所有候选目标的边界框,再根据指令筛选出需要点击的那些,算出中心坐标,依次提交。另一条是逆向路线:不自己识别,而是想办法让官方 JS 把答案算出来,或者从加密前的明文里直接读取坐标。 第一条路线听起来合理,但成本不低。目标检测模型需要针对特定图标库训练或微调,OCR 对艺术字和旋转文字的识别率会下降,顺序约束又增加了一层逻辑判断。更重要的是,点选题的图标库和指令模板会更新,模型需要跟着重新训练或调整。 第二条路线(逆向)的工程量更大。以极验的点选为例,答案的坐标编码方式涉及图片在页面上的实际渲染尺寸、缩放比例、裁剪偏移。光读代码很容易算错,因为 rect 到底对应哪个元素、图片被缩放了多少,只有在真实浏览器环境里测量才能确定。有的方案选择给官方 JS 打最小补丁,把内部计算答案的方法暴露出来,再由外部调用,让 SDK 自己产出最终的加密参数。这本质上是在和验证码厂商的代码更新赛跑。 两条路线都有一个共同的天花板:你破解的是当次挑战,不是这套系统。 下次换一批图、换一组指令、换一个加密版本,方案就需要重新适配。 为什么机器人越来越难:成本曲线在往上走把滑块和点选的破解思路放在一起看,会发现一个关键差异:字符验证码的破解成本是一条平线,滑块和点选是一条陡峭上升的曲线。 字符验证码的破解核心是 OCR。OCR 模型一次训练,可以长期使用,识别一张图的边际成本几乎为零。打码平台把这件事做成了流水线,几块钱就能过一千次。攻击者的投入是一次性的,产出是持续的。 滑块和点选则不是。缺口定位可以复用,但轨迹模型需要不断调;图标识别模型需要跟着题库更新;加密参数需要跟着版本逆向;环境伪装需要跟着检测规则升级。攻击者面对的不是一道题,而是一个持续变动的系统。每一次验证码服务端更新题面、调整行为模型、更换加密逻辑,攻击者之前投入的一部分工作就会失效。 这就是注册机越来越难的根本原因。一个能稳定批量注册的脚本,需要同时维持图像识别、轨迹生成、环境伪装、协议逆向、会话管理五条以上的技术栈,而且每一条都要跟着对手的更新节奏维护。对于想批量制造假账号的人来说,这笔持续投入相对于能拿到的账号价值,越来越不划算。 这里可以一笔带过的是,优雅草人机盾这类产品做的正是这件事:把滑块和点选作为默认题型,把服务端校验、来源绑定、场景绑定和一次性 token 串成一条完整链路,同时提供智能接入能力,让 AI 编程助手按提示词直接把验证接到业务里。它不靠“题面更难”取胜,靠的是让绕过的一方需要持续投入,而维护的一方只需要按节奏更新。 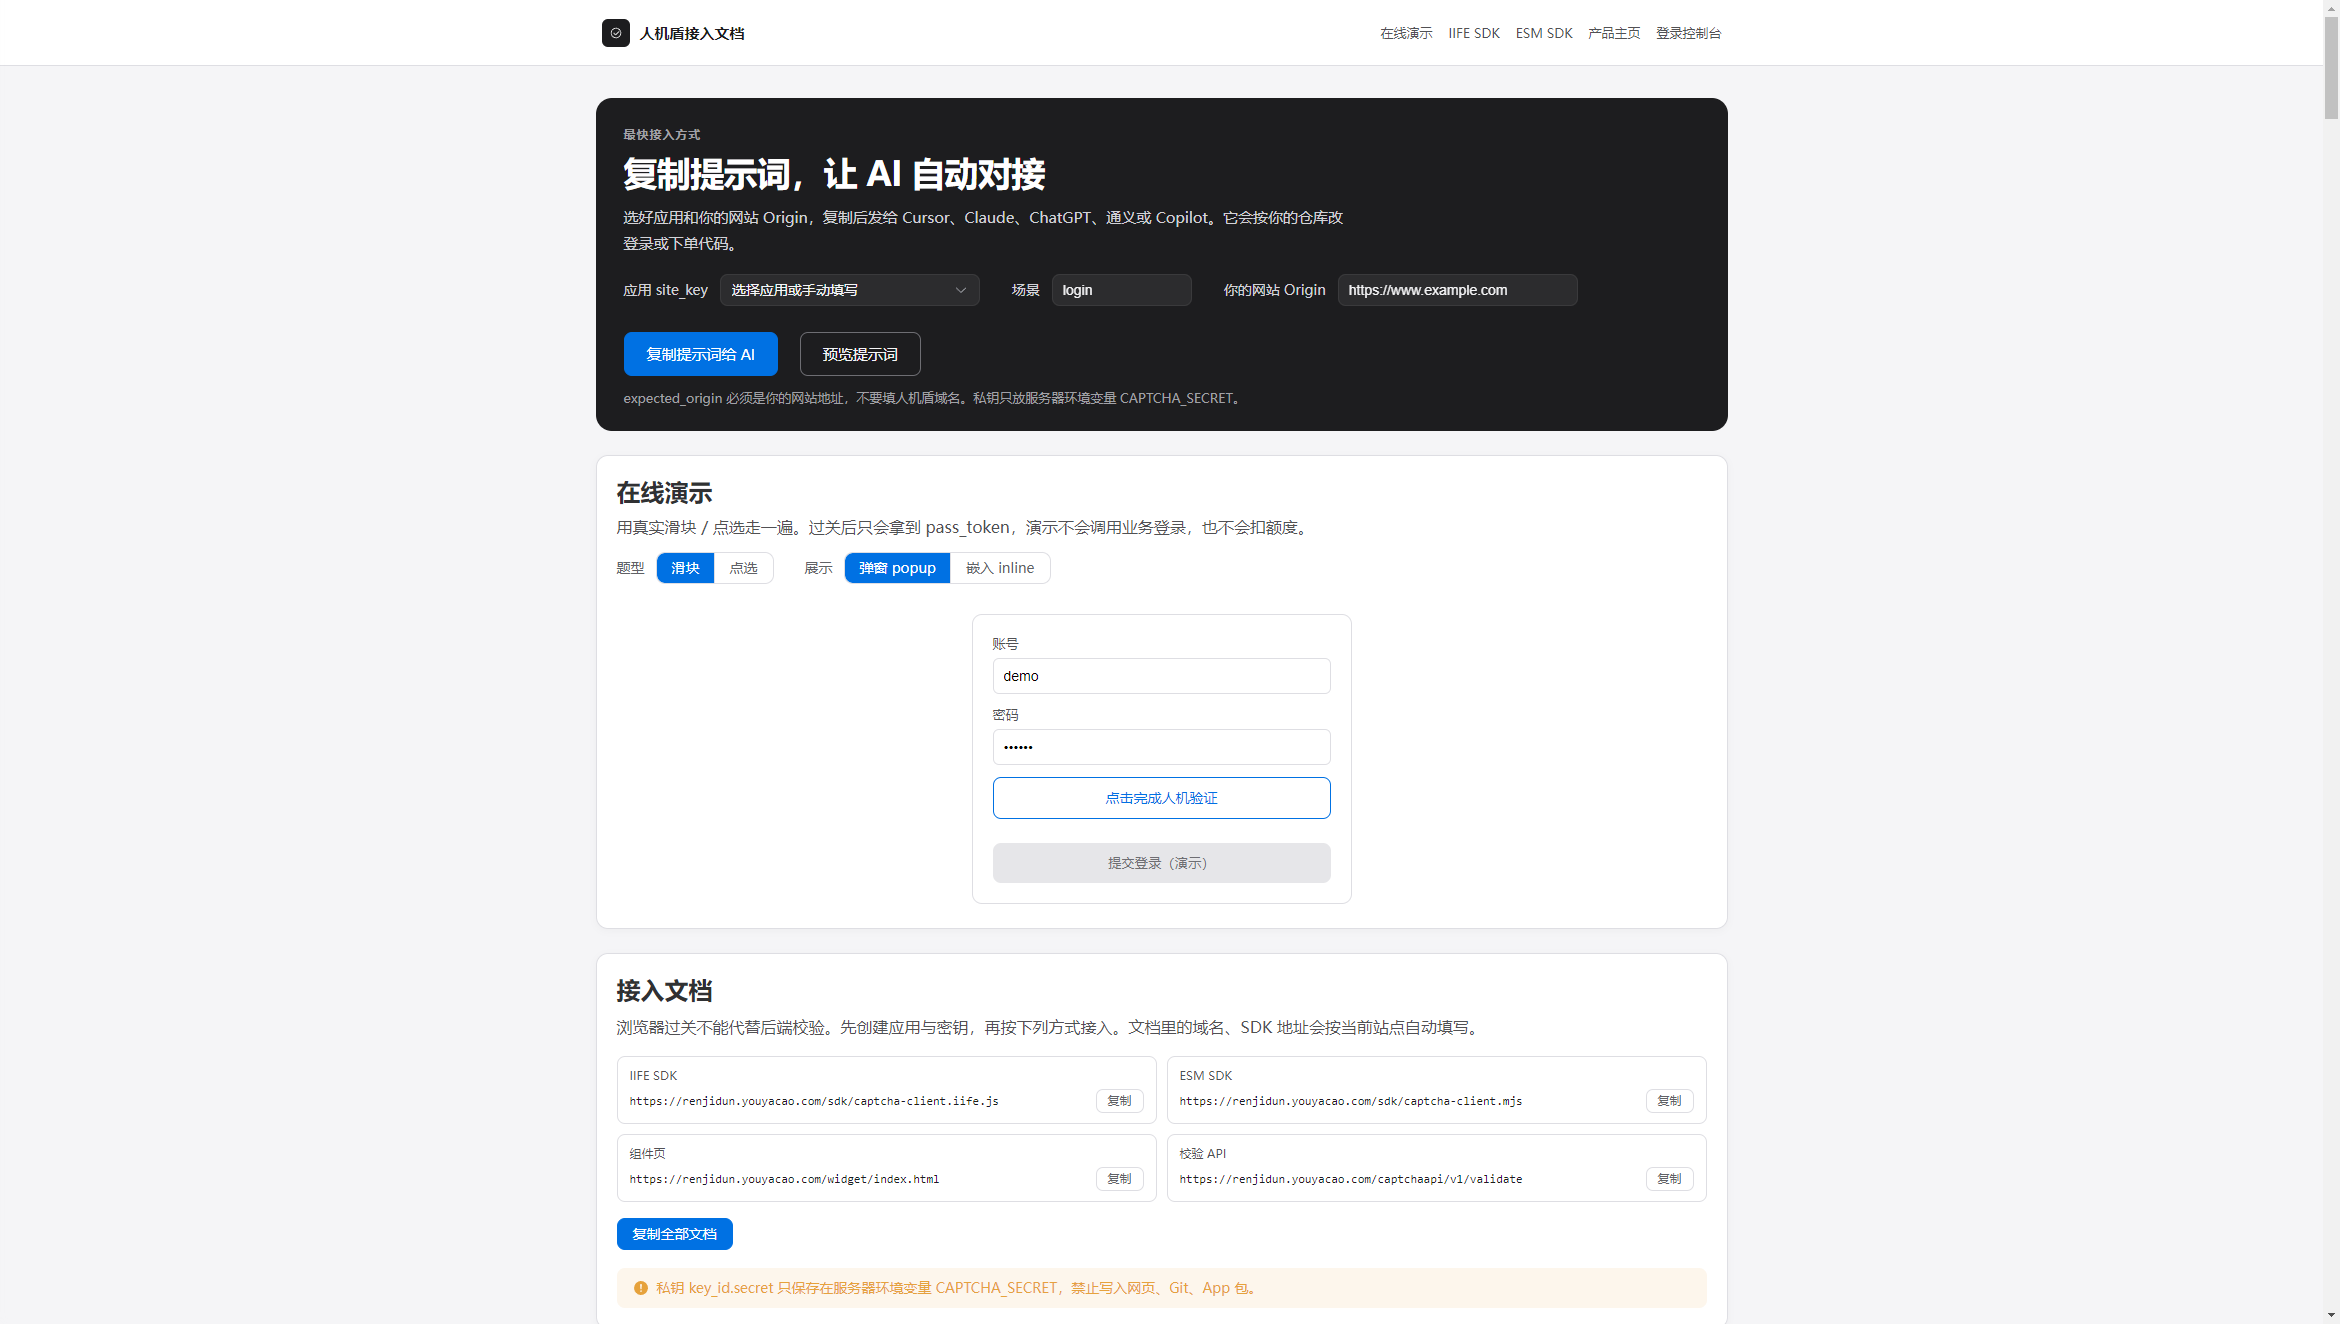 滑块为什么正在普及:不是因为它完美,是因为账算得过来2026 年的现实是,字符验证码在 OCR 和打码平台面前已经基本失守。继续把它当作注册和登录的默认防线,等于给脚本留了一扇没锁的门。 滑块和点选不是无懈可击的。学术研究早就证明,特定条件下滑块可以被较高成功率地攻击。但“可以被攻击”和“攻击成本低到值得做”是两件事。一个需要逆向加密、模拟行为、维护模型、跟版本更新的绕过方案,和一个调用打码 API 就能跑通的字符破解方案,中间差着数量级的投入。 对于绝大多数业务场景——注册、登录、找回密码、下单、领券、发帖——需要的不是绝对安全的验证码,而是一个让批量脚本觉得不划算的拦截层。滑块和点选恰好卡在这个位置上:真人顺手一滑或点几下就过了,机器要过就得付出不成比例的持续成本。 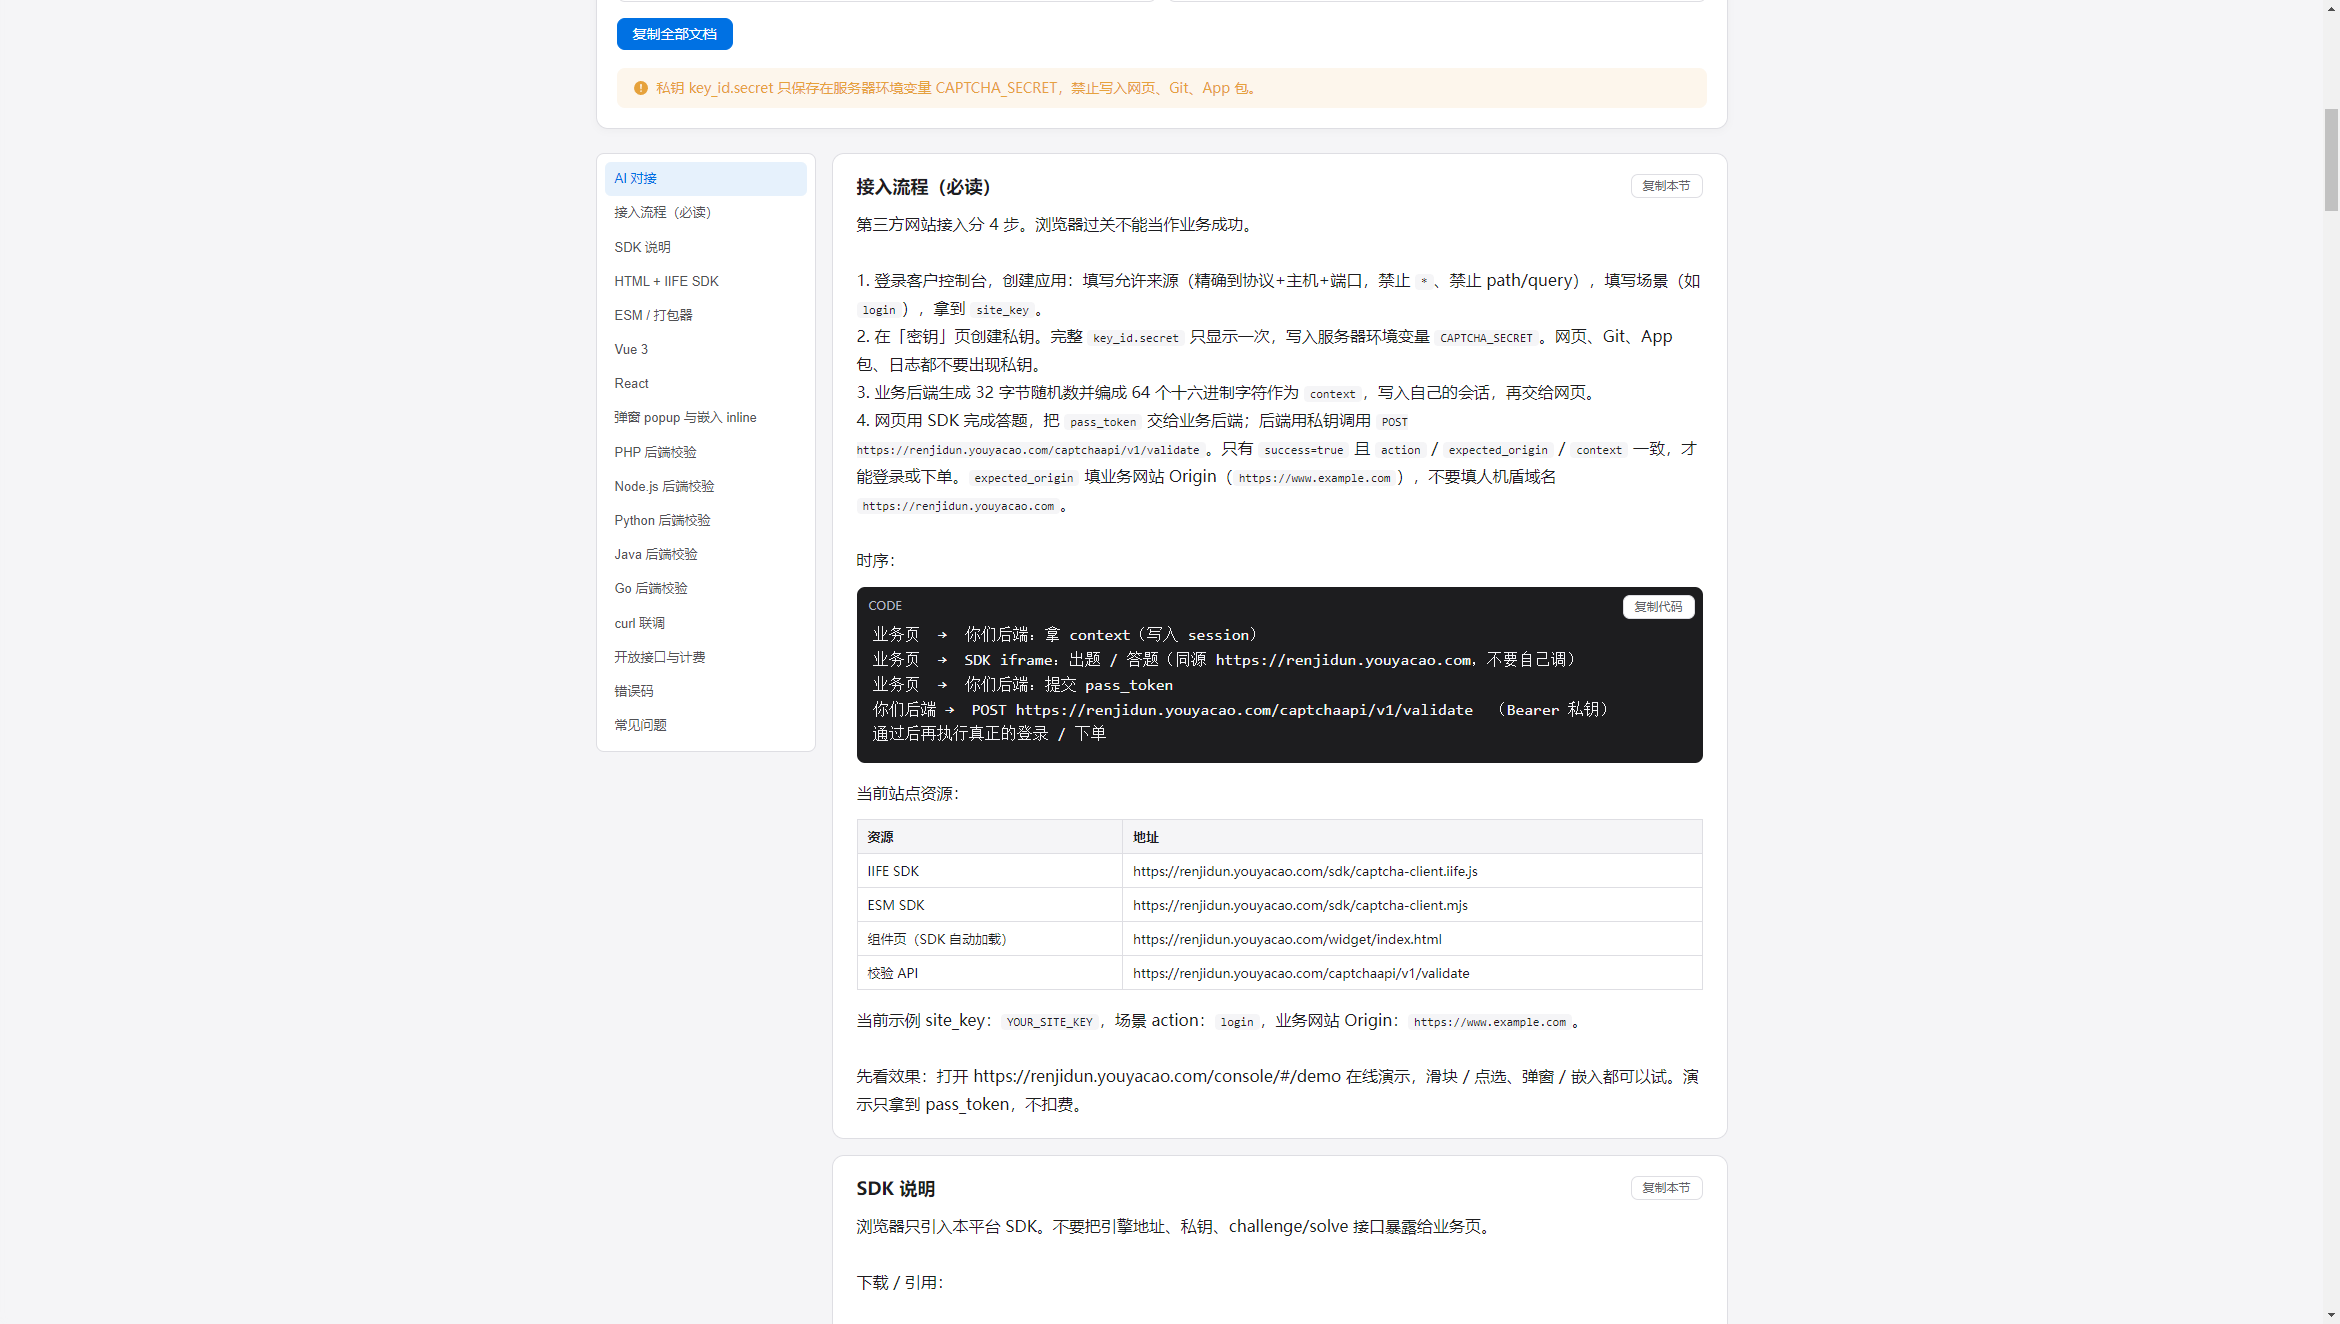 所以滑块和点选的普及,本质上不是技术审美的胜利,是攻防经济学的结果。当绕过一扇门的成本超过了门后东西的价值,这扇门就算不上完美,也已经够用了。
|