|
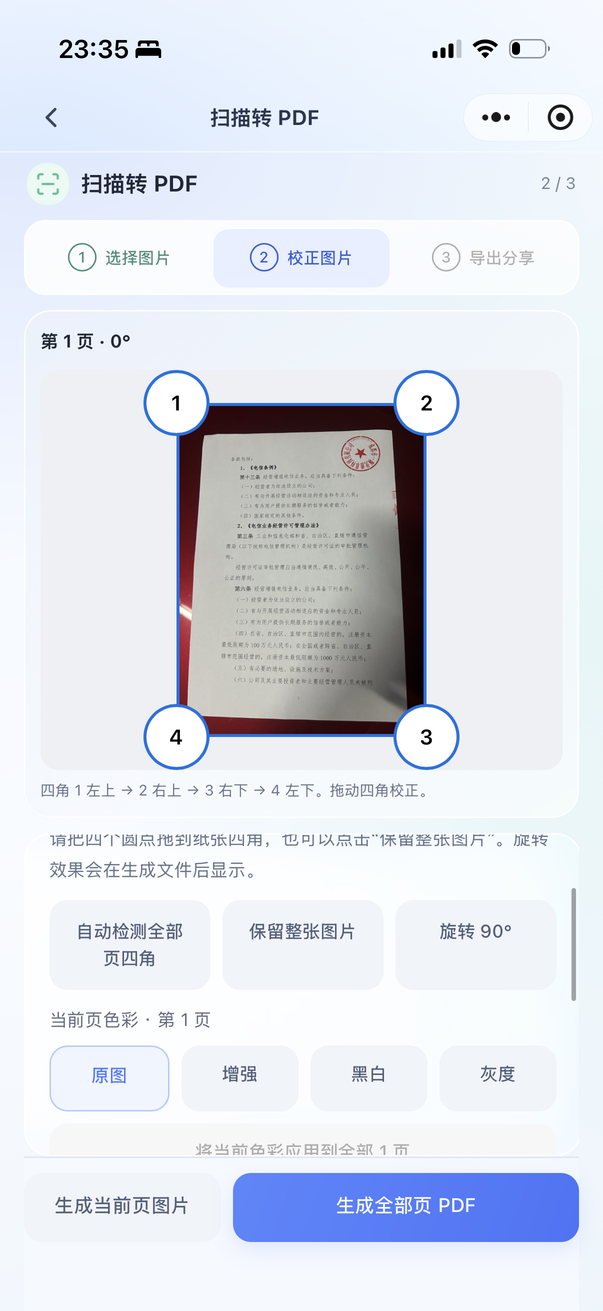
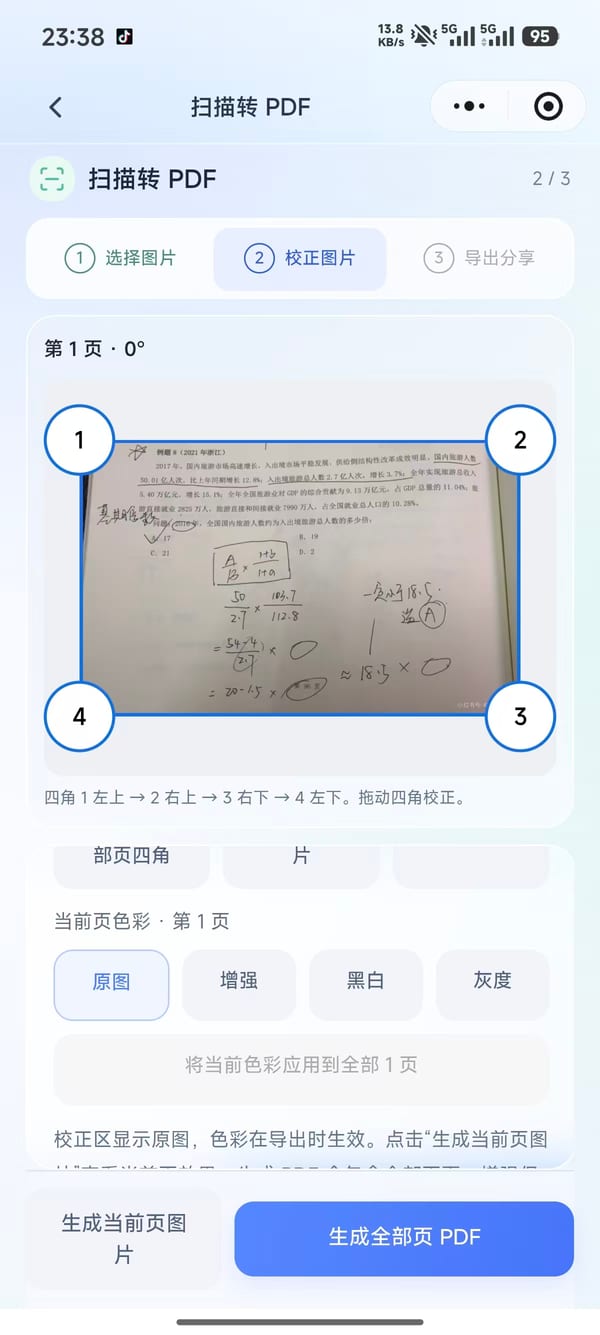
扫描转PDF技术的软件化重构:从硬件受控成像到算法校正流水线 扫描转PDF技术从硬件设备走向手机应用,本质上是一场图像处理流水线的软件化重构。过去依赖精密光学组件和机械结构完成的“数字化”工作,如今被拆解为四个可计算步骤:边缘检测、透视校正、图像增强、格式封装。手机扫描App所做的,就是用算法在通用摄像头上重建这条流水线。 从硬件扫描到软件扫描:技术范式的转移传统平板扫描仪的工作原理是固定光源、固定传感器、线性移动。CCD或CIS传感器在步进电机驱动下匀速扫过纸面,每一行像素的几何关系天然已知,因此几乎不需要后续的几何校正。它的核心优势在于成像条件受控,代价是设备昂贵、便携性为零。2013年前后,一台普通平板扫描仪对个人用户而言仍是不小的开支,更不用说外出场景下完全无法使用。  手机扫描的起点则完全不同:摄像头位置任意、光照不可控、镜头存在畸变。拍出来的纸张大概率是一个不规则的四边形,且伴随透视变形。技术演进的关键就在于:如何用软件把这张“歪的”照片,还原成扫描仪输出的“正的”图像。 校正技术:从透视变换到深度学习第一步是找边界。 手机扫描App首先需要从背景中把纸张“抠”出来。经典做法是基于边缘检测(如Canny算子)结合霍夫直线变换,寻找图像中显著的直线段,进而拟合出文档的四个角点。这一步在背景干净、对比度足够时表现尚可,但遇到复杂桌面或纸张边缘与背景颜色接近时容易失效。 第二步是透视校正。 找到四个角点后,算法利用透视变换(Perspective Transform)将不规则四边形映射为标准矩形。数学上,这等价于求解一个3×3的单应性矩阵,需要四组对应点——拍摄图的四个角点,以及目标矩形的四个顶点坐标。目标矩形的宽高比通常根据常见纸张规格(如A4的√2:1)预设,或由用户手动选择。这一步能有效消除因拍摄角度造成的梯形畸变,把“斜着拍”的纸张拉回正视视角。 第三步是曲面与残留畸变的处理。 透视变换只能解决平面假设下的角度问题。书本翻开时页面弯曲、纸张本身有折痕,这些非平面形变无法用单应性矩阵描述。近年来的技术进展集中在这里:扫描全能王等头部产品引入了基于深度学习的曲面检测与矫正,通过训练模型识别书页的弯曲模式,再做非刚性形变校正。Adobe Scan则提供了“页面拉直”工具,即便用户拍摄时没有完整拍到四个角,也能尝试推断并校正。开源实现“拾序”在透视校正之后,还会用文字行检测做二次校准,进一步消除正文的轻微横向倾斜。 增强与导出:从“拍清楚”到“像扫描件”校正解决的是几何问题,增强解决的是光度问题。手机拍摄的文档常伴有阴影、色偏、手指遮挡、屏幕摩尔纹等干扰。传统流程是用户手动调节亮度、对比度、锐度;现代扫描App则把这些决策交给算法。 以扫描全能王的“智能高清滤镜”为例,其流程是:先用深度学习模型感知图像中的光照分布、阴影区域、颜色偏差和倾斜角度,再根据判定结果选择对应的处理策略——如果是过暗且偏黄的室内灯光拍摄,就做白平衡校正与局部提亮;如果检测到手指遮挡,则尝试用周边纹理填充或标记为待清理区域。Adobe Scan的“魔法橡皮擦”则提供了一键去除污渍、折痕、手指的功能,本质上是基于语义分割的缺陷检测与修复。 增强完成后的格式封装相对简单:将处理后的多页图像按顺序编码为PDF容器。PDF格式的优势在于跨平台一致性和分页结构,适合归档与分享。部分App还叠加了OCR层,使输出PDF的文字可搜索、可复制,但这已属于扫描之后的附加处理。 技术栈的成熟与分化这条技术链的成熟度可以从开源项目的完整性窥见一斑。“拾序”作为一个iPhone本地扫描App,公开了其完整链路:Apple Vision框架负责文档分割与矩形检测,自定义透视变换做几何校正,文字行检测做二次对齐,最后原生写入A4多页PDF。这意味着扫描转PDF的核心算法已经不再是大厂独占的壁垒,而是可以被独立开发者复现和定制的标准化流程。 不同产品之间的差异,更多体现在边界场景的处理能力上:对弯曲书页的矫正精度、对复杂背景的鲁棒性、对多语种OCR的支持广度。底层数学原理是共通的,工程优化程度决定了体验差距。
顺带一提,优雅草即将于11月3日发布的万能图王,也将在产品侧集成扫描转PDF能力,把上述校正与导出链路打包为可直接使用的功能。不过本文的重点仍在技术本身的演变逻辑:从依赖精密机械的物理扫描,到用算法在手机摄像头上“重建”扫描条件——这十年的变化,本质上是把一件专用硬件做的事,拆解成了几行可复用的数学运算。
|