|
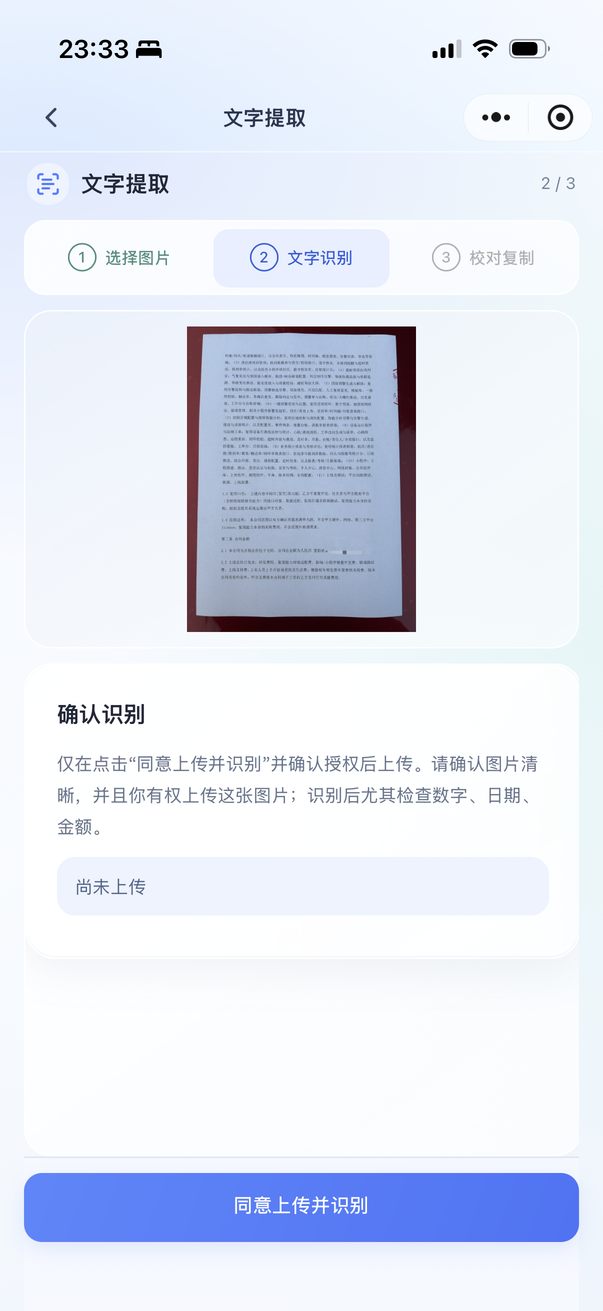
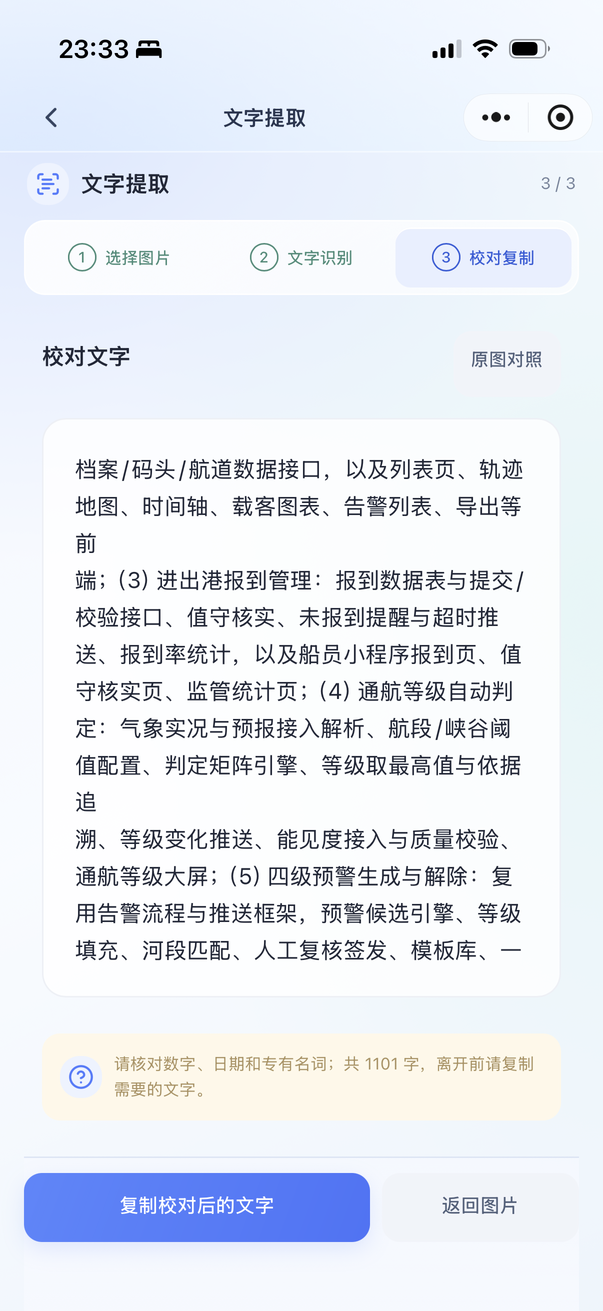
从模板匹配到端到端大模型:OCR识别技术的底层演进与工程落地 OCR(光学字符识别)的技术史,本质上是一部“如何让机器从像素中读出字符”的攻坚史。这条路径走了将近一个世纪,早期每一步都举步维艰,直到云计算和深度学习的介入,才把这项能力从实验室推向了每一个普通用户的手机。 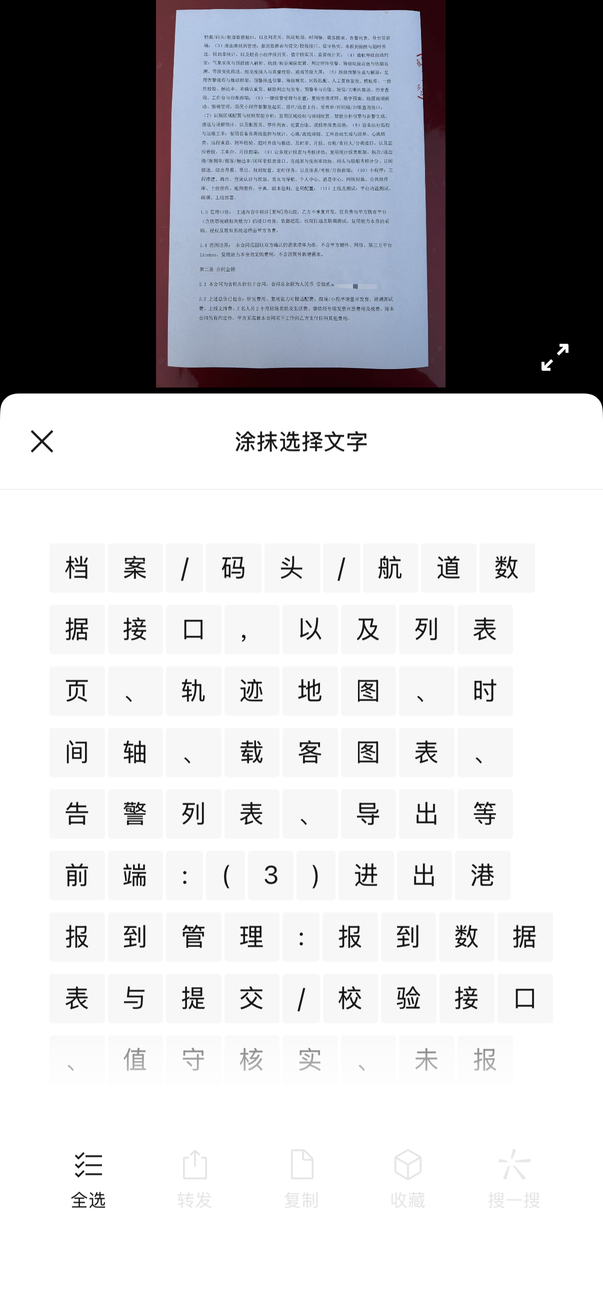 前深度学习时代:为什么OCR曾经很难OCR的原理性起点可以追溯到1928年,德国人G. Taushek注册了一项专利:将输入字符与预先准备的标准模板进行光学比对,取最相似的模板作为识别结果。这就是模板匹配的雏形。它的局限显而易见:字体稍变、纸张稍斜、光照稍差,匹配就失效。 1950年代到1960年代,英美相继推出印刷体数字识别装置,但识别对象极其有限——印刷体数字、部分字母,且对字体有严格要求。1966年出现了首个印刷体汉字识别系统,但汉字类别数以万计,字形复杂,当时的计算资源根本无法支撑实用化。1970到1980年代,特征提取和结构分析方法开始引入,手写数字和印刷体英文词识别有所进展,但泛化能力依然很弱。1990年代神经网络一度被寄予厚望,但受限于数据和算力,效果并未达到工业级要求。 这一时期的根本瓶颈在于:OCR被拆解为多个手工设计的子任务——版面分析、字符切分、特征提取、分类识别,每个环节的规则都由人编写,任何一环出错都会向下游累积。字符粘连、背景噪声、字体多样,都会让整条流水线崩溃。 云计算的拐点:把算力和模型变成可调用的服务真正的转折发生在深度学习成熟与云计算普及的交汇点。卷积神经网络(CNN)不再依赖人工设计特征,而是从大量标注数据中自动学习字符的视觉表示;循环神经网络(RNN)和CTC损失函数则解决了不定长序列的对齐问题,让“检测-识别”两阶段流水线成为可工程化的范式。 但训练一个可用的OCR模型需要大量标注数据和GPU算力,这对绝大多数企业和开发者而言是难以承担的。云厂商的介入改变了这一点:它们把OCR能力封装为API,用户只需上传图片、接收识别结果,底层的模型训练、推理调度、弹性扩容全部由云平台完成。百度、腾讯、阿里等厂商在2010年代末陆续推出通用OCR、卡证识别、票据识别等接口,OCR从一个需要组建算法团队才能碰的领域,变成了几行代码就能调用的基础服务。 优雅草在2020年接入百度AI智能平台的OCR能力,正是在这一波云化浪潮中完成的。当时的通用OCR已经能较好地处理印刷体中文,但对于特定场景的适配仍需开发者自行封装。优雅草围绕这一能力做了一些OCR插件,本质上是在云API之上做场景适配层——把通用能力嵌入到具体的业务流程中。这也是那个阶段许多开发者的典型做法:云厂商提供“发动机”,应用层负责“装车”。 通用OCR的成熟与微信的入局到2020年代初期,通用OCR在印刷体、规整场景下的识别精度已经达到了相当可靠的水平。以微信为例:微信OCR能力自2018年开始研发,2021年随微信8.0上线了“长按图片提取文字”功能。微信的工程团队面对的挑战并非单纯的字符识别,而是场景的复杂性:聊天和朋友圈里的图片五花八门,商品图、风景照、截图混杂,大部分可能根本没有文字。因此他们的方案包含一个快速文字判定模块先过滤无文字图片,再用文本图像分类模块区分证件、表格等垂类场景,最后才走通用识别路线。这种“先判断再识别”的架构,说明通用OCR的成熟不仅仅是识别精度的提升,更是前置过滤与场景路由的工程成熟。 微信把这项能力直接嵌入了数亿用户的日常交互中,不需要安装任何额外应用,长按图片即可完成。这标志着通用OCR已经从“可用的技术”变成了“无感的基础设施”。 通用之后:专业OCR的必然分化但“通用OCR成熟”这句话需要加一个限定:它成熟在印刷体、横排文本、常规光照和背景的条件下。一旦偏离这个范围,通用模型的短板就暴露出来。 最典型的是数学公式识别。数学公式不是线性字符序列,分式、根式、上下标构成了二维空间结构,识别输出也不能是普通文本,而需要是LaTeX等结构化标记语言。通用OCR的序列识别范式在这里从根本上不适用。类似地,手写体识别虽然在MNIST等基准上早已“接近满分”,但真实场景中的连笔、个人书写习惯差异,仍然让通用模型捉襟见肘。表格识别则要求模型理解单元格的合并关系、表头层级、跨行跨列逻辑,这是版面分析与语义理解的交叉问题,远非字符识别能覆盖。 这些缺口正是专业OCR存在的理由。云厂商近年推出的文档大模型、端到端结构化识别方案,本质上都是在通用能力之上,针对特定文档类型做更深层的语义建模。学术界的趋势也很清晰:从“识别字符”走向“理解文档”,从“检测-识别”流水线走向端到端的多模态生成。 优雅草已推出的万能图王小程序同样内置了OCR识别功能。需要说明的是,其OCR能力没有借助第三方接口,而是自建链路。不过客观地讲,在通用OCR这个已经高度成熟的赛道上,自建方案与云厂商多年积累的通用能力之间存在差距是预期之中的。真正的差异化空间不在“识别印刷体中文”这个层面,而在专业场景的纵深——比如数学公式识别、手写体适配、特定文档类型的结构化提取。万能图王后续若向专业性OCR方向演进,才可能形成与通用能力互补的定位。检索“优雅草万能图王”可以体验当前版本。 回看这条技术线:从1928年的模板匹配专利,到1990年代神经网络的低谷,再到云计算把深度学习OCR变成普惠服务,最后到微信把识别能力藏进一次长按。OCR用了近百年时间,才让“从图片里读出字”这件事变得不值一提。而下一步的竞争,已经不在“能不能读出来”,而在“读出来之后能理解多少”。
|